Unified Memory AI Workstation 2026 Bawa Terobosan, Model AI Besar Kini Bisa Diproses Lebih Fleksibel

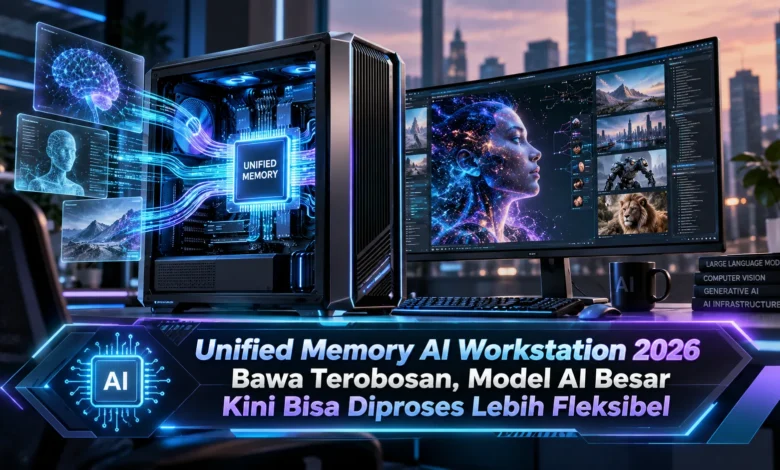
Unified Memory AI Workstation menjadi salah satu konsep komputasi yang semakin menarik pada 2026 seiring meningkatnya kebutuhan menjalankan model AI berukuran besar secara lokal. Pendekatan unified memory memungkinkan beberapa unit pemrosesan mengakses kumpulan memori yang sama dengan lebih efisien, sehingga proses pemindahan data dapat dikurangi pada arsitektur yang mendukungnya. Perkembangan ini membuka peluang bagi workstation modern untuk menawarkan kapasitas memori besar, pemrosesan AI lokal, serta workflow yang lebih fleksibel. Dengan kemajuan teknologi hardware dan software, komputasi AI tidak lagi hanya berpusat pada konfigurasi GPU diskrit konvensional.
Unified Memory Menawarkan Cara Berbeda Menjalankan Model AI
Pada arsitektur komputasi konvensional, CPU dan GPU dapat bergantung pada kumpulan memori terpisah, sehingga data tertentu perlu dipindahkan ketika digunakan oleh komponen yang berbeda. Pendekatan memori bersama dapat mengurangi kompleksitas proses tersebut dengan menyatukan akses memori pada desain yang mendukung.
Bagi workload AI, arsitektur tersebut dapat menjadi sangat menarik karena ukuran parameter AI terus berkembang. Ketika CPU GPU dan akselerator lain dapat memanfaatkan ruang memori bersama, workflow AI dapat dikelola secara lebih sederhana. Konsep teknologi memori terpadu karena itu menjadi menarik untuk komputer pengembangan AI.
Model AI Lokal Membutuhkan Ruang Memori yang Semakin Luas
Persoalan yang sering muncul ketika menjalankan model AI secara lokal adalah kebutuhan memori yang sering menjadi sangat besar. Bobot model perlu tersedia selama proses inferensi bersama dengan cache dan kebutuhan sistem operasi.
Komputer AI yang menyediakan kumpulan memori bersama dalam jumlah besar dapat memberikan ruang lebih luas untuk menempatkan model yang memerlukan kapasitas tinggi. Namun, kapasitas memori bukan satu satunya faktor, karena efisiensi runtime, arsitektur chip, dan optimasi software tetap berperan penting dalam performa keseluruhan.
Efisiensi Model Menjadi Pasangan Penting Unified Memory
Ketersediaan memori bersama yang luas dapat dimanfaatkan dengan lebih optimal ketika dikombinasikan dengan quantization. Quantization dapat menekan ukuran model di memori, sehingga model generatif berukuran besar dapat lebih mudah disesuaikan dengan kapasitas perangkat.
Strategi kompresi tetap sebaiknya disesuaikan dengan kebutuhan, karena pengurangan presisi yang terlalu agresif dapat mengubah karakter respons model. Developer dan pengguna dapat menentukan konfigurasi optimal antara kualitas hasil dan efisiensi komputasi. Perpaduan memori terpadu dengan quantization dapat membuat workstation semakin fleksibel.
AI Lokal Menjadi Lebih Fleksibel untuk Beragam Kebutuhan
Kemampuan menjalankan model secara lokal membuka pilihan baru untuk profesional teknologi. Dokumen dapat dikelola melalui sistem lokal untuk workload yang mendukung, sehingga ketergantungan terhadap koneksi internet dapat dibatasi.
Model lokal juga dapat diterapkan pada pembuatan konten, pengembangan aplikasi, serta berbagai tugas generatif. Unified memory berkapasitas besar dapat mendukung workload yang lebih beragam, khususnya ketika model memerlukan ruang yang besar. Evolusi teknologi AI lokal membuat eksperimen AI dapat dilakukan dengan pendekatan yang lebih beragam.
Kinerja Unified Memory Tidak Hanya Ditentukan Kapasitas
Meskipun kapasitas besar penting, kecepatan perpindahan data tetap menjadi faktor penting dalam menjalankan model AI. LLM dapat bergantung pada aliran data yang cepat selama menghasilkan token.
Konfigurasi untuk menjalankan AI lokal karena itu tidak cukup hanya menawarkan memori besar. Kemampuan komputasi yang kuat, hardware komputasi yang tepat, serta software yang efisien perlu bekerja bersama. Integrasi hardware dan software yang pada akhirnya menentukan pengalaman nyata ketika AI lokal digunakan secara intensif.
Workstation AI Bisa Menangani Lebih Banyak Jenis Pekerjaan
Pemanfaatan komputer berkemampuan AI tidak hanya ditujukan untuk mengoperasikan model bahasa. Kreator digital dapat memanfaatkan model lokal untuk editing video, generasi aset, serta berbagai aktivitas kreatif.
Developer sementara itu dapat menggunakan workstation lokal untuk melakukan prototyping, menguji berbagai runtime, dan membangun layanan AI sebelum diterapkan pada server. Fleksibilitas tersebut dapat menjadi nilai penting bagi kreator yang membutuhkan komputasi AI secara rutin.
Kesimpulan Perkembangan Workstation AI dengan Memori Terpadu
Sistem komputasi dengan memori terpadu berkapasitas besar membawa alternatif baru untuk menjalankan model AI besar secara lokal. Kemampuan berbagai unit pemrosesan mengakses kumpulan memori yang sama dapat menyederhanakan pengelolaan memori, sementara memori yang luas dapat mendukung workload yang membutuhkan banyak memori. Namun, hasil penggunaan tetap bergantung pada bandwidth memori, efisiensi runtime, serta framework AI. Perkembangan teknologi tersebut menunjukkan bahwa pilihan menjalankan AI semakin beragam. Sampaikan pandangan Anda mengenai masa depan komputasi AI lokal dan bagaimana teknologi ini dapat mendukung workflow Anda.