Tips Mengoptimalkan GPU untuk AI agar Stabil, Strategi Praktis Tingkatkan Kecepatan Pemrosesan

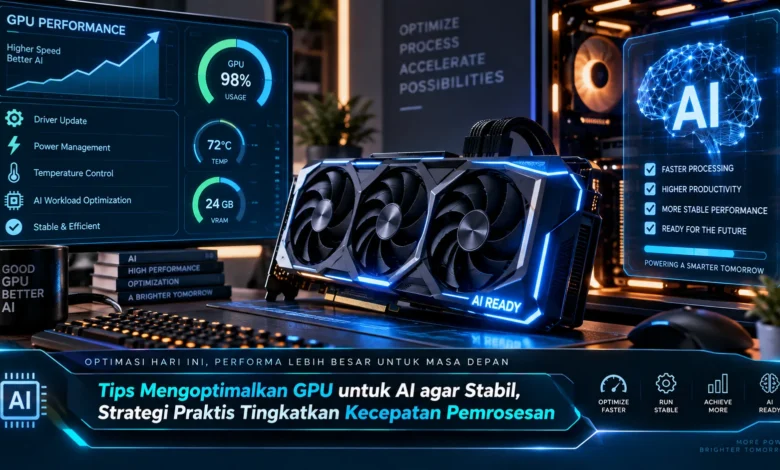
GPU menjadi komponen penting ketika menjalankan berbagai workload AI karena mampu menangani banyak operasi komputasi secara paralel. Namun, kartu grafis dengan spesifikasi tinggi belum tentu memberikan performa maksimal apabila VRAM, suhu, driver, framework, hingga konfigurasi model tidak dikelola dengan tepat. Optimasi yang seimbang dapat membantu meningkatkan kecepatan sekaligus menjaga stabilitas sistem, sehingga pemanfaatan TEKNOLOGI AI menjadi lebih efisien untuk inferensi maupun pekerjaan komputasi lainnya.
Kenali Beban Kerja Sebelum Mengoptimalkan GPU
Langkah awal dalam mengoptimalkan GPU ialah mengetahui kebutuhan komputasi dari model yang digunakan. Setiap model dapat memiliki kebutuhan yang berbeda. Beberapa workload sangat bergantung pada memory GPU, sedangkan workload berbeda dapat lebih bergantung pada throughput komputasi.
Pengamatan performa dapat memberikan gambaran mengenai beban sistem. Aktivitas GPU, kapasitas VRAM terpakai, beban CPU, konsumsi RAM, temperatur, dan performa pemrosesan dapat dipantau pada saat aplikasi AI aktif. Jika GPU sering menganggur sementara CPU bekerja sangat tinggi, konfigurasi workload perlu diperiksa sebelum meningkatkan kemampuan GPU. Strategi berbasis pengukuran tersebut membuat optimasi TEKNOLOGI AI lebih terarah.
Manajemen Memory GPU Menjadi Kunci Performa AI
Kapasitas memori grafis menjadi faktor utama dalam menjalankan model yang membutuhkan banyak parameter. Parameter model membutuhkan ruang pada VRAM, sedangkan cache serta berbagai data pemrosesan menggunakan ruang lainnya. Apabila memory GPU terlalu penuh sebelum workload meningkat, sistem dapat mengalami penurunan performa atau kegagalan pemrosesan.
Pengguna dapat mengurangi aplikasi lain yang memakai akselerasi GPU. Browser, program kreatif, game, editor multimedia, dan berbagai aplikasi berbasis GPU berpotensi mengurangi memory yang tersedia untuk model. Menyisakan sebagian memory GPU dapat membantu mempertahankan stabilitas ketika kebutuhan workload berubah. Strategi penggunaan VRAM tersebut menjadi salah satu cara praktis mengoptimalkan TEKNOLOGI AI.
Quantization Membuat Model Lebih Ringan untuk GPU
Pengurangan precision merupakan salah satu pendekatan efektif agar model AI menggunakan sumber daya lebih sedikit. Bobot model menggunakan precision besar umumnya membutuhkan kapasitas memory lebih banyak. Menerapkan format model yang lebih ringan dapat mengurangi ukuran serta kebutuhan memory.
Konfigurasi quantization perlu dipilih berdasarkan workload. Pengaturan yang lebih agresif dapat memberikan penghematan memory lebih besar, namun hasil pemrosesan tertentu dapat mengalami perbedaan. Perbandingan beberapa tingkat precision dapat digunakan untuk mencari titik optimal berdasarkan perangkat. Sasaran optimasi tersebut adalah membuat TEKNOLOGI AI berjalan efisien sesuai kapasitas hardware.
Konfigurasi Batch Size Membantu Menjaga Performa GPU
Ukuran batch dapat menentukan bagaimana sumber daya grafis dimanfaatkan. Ukuran batch yang lebih tinggi berpotensi meningkatkan jumlah data yang diproses dalam satu periode, meski tekanan terhadap memory GPU juga menjadi lebih besar. Memaksakan ukuran batch di luar kapasitas hardware berpotensi menyebabkan kegagalan alokasi VRAM.
Context juga perlu diperhatikan pada model yang memproses urutan panjang. Jumlah token yang besar berpotensi menambah konsumsi VRAM. Jika tugas hanya membutuhkan informasi terbatas, memaksakan context besar justru dapat memboroskan sumber daya. Menggunakan pengaturan konservatif kemudian melakukan penyesuaian berdasarkan monitoring menjadi strategi praktis untuk menjaga TEKNOLOGI AI tetap responsif.
Kurangi Bottleneck dengan Pembagian Workload yang Tepat
Performa tinggi pada GPU belum tentu langsung menghasilkan pemrosesan cepat apabila data tidak dapat dikirim dengan efisien. Prosesor sering menangani sebagian pekerjaan sebelum informasi dikirim ke kartu grafis, sementara RAM dan storage menyediakan informasi yang diperlukan. Apabila salah satu komponen menjadi hambatan, pemrosesan AI dapat melambat walaupun GPU belum bekerja penuh.
Pembagian workload antara CPU dan GPU harus diperhatikan. Jika model tidak sepenuhnya muat di VRAM, offloading dapat digunakan agar workload tetap berjalan. Meski demikian komunikasi yang terlalu intensif antara CPU dan GPU berpotensi menurunkan kecepatan pemrosesan. Pengaturan sumber daya yang tepat dapat membantu menjaga stabilitas sekaligus mempertahankan kecepatan.
Jaga Suhu dan Software agar GPU Tetap Stabil
GPU yang menjalankan workload AI dalam waktu panjang dapat menghasilkan panas dalam jumlah cukup besar. Jika suhu meningkat terlalu jauh, perangkat dapat menurunkan kecepatan untuk melindungi komponen. Penurunan frekuensi tersebut dapat membuat inferensi yang awalnya cepat menjadi semakin lambat.
Aliran udara dan kebersihan sistem pendinginan perlu diperhatikan. Software GPU dan runtime pemrosesan harus menggunakan kombinasi yang sesuai. Kombinasi driver, backend komputasi, dan framework yang stabil berpotensi mengurangi masalah yang sebenarnya berasal dari software. Keseimbangan hardware dan software tersebut dapat meningkatkan keandalan TEKNOLOGI AI ketika digunakan secara intensif.
Optimasi GPU yang Seimbang Membantu AI Berjalan Lebih Cepat
Optimalisasi kartu grafis untuk workload AI perlu memperhatikan performa sekaligus keandalan sistem. VRAM, quantization, batch, context, CPU, RAM, transfer data, temperatur, driver, dan framework harus dikelola agar tidak saling menciptakan bottleneck. Melalui optimasi yang dilakukan secara menyeluruh, GPU dapat digunakan secara lebih efisien untuk menjalankan model AI.
Pengukuran sistem merupakan langkah utama untuk memastikan perubahan benar benar bermanfaat. Setiap model dan perangkat dapat memberikan hasil berbeda, maka pengaturan sebaiknya disesuaikan berdasarkan hasil nyata. Pemanfaatan TEKNOLOGI kecerdasan buatan menjadi lebih efisien saat seluruh komponen bekerja selaras. Pengguna dapat membandingkan hasil setiap konfigurasi agar menemukan pengaturan paling sesuai.